Routage MoE entre GPU
Avi Chawla — 28 septembre 2026 (Traduction française de l'article original source
Comment fonctionne le routage MoE entre des GPU distribués ? Un bon sujet d'interview technique AI.
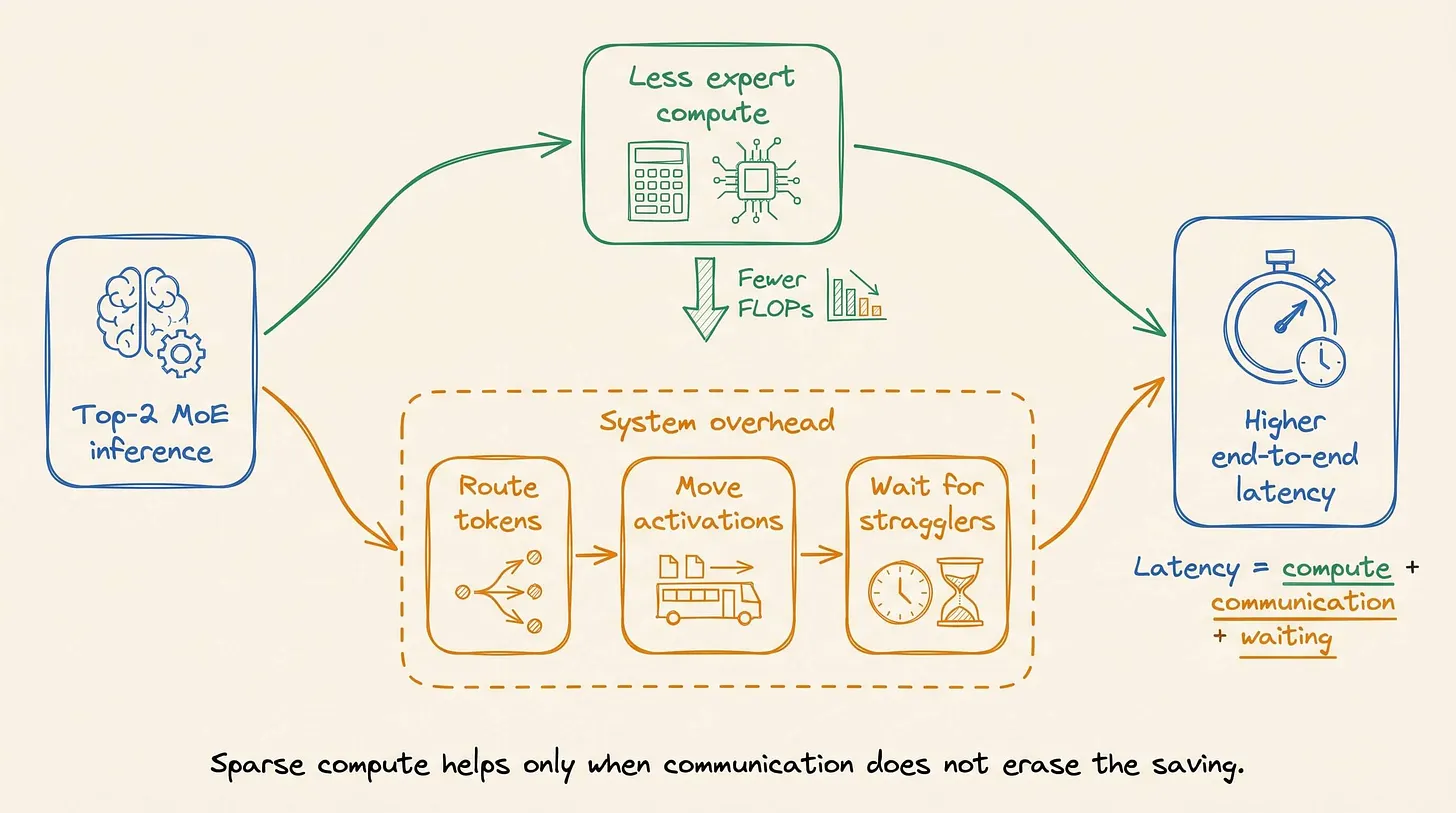
Vous remplacez une couche de MLP dense (feed-forward) par un MoE top-2. Le profiler confirme que le MoE exécute moins de FLOPs par token.
Pourtant, la latence d'inférence de bout en bout a augmenté au lieu de diminuer.
 Pourquoi ?
Une couche de Transformer standard applique le même réseau feed-forward (Réseau de neuronnes interne aussi appelé MLP qui signifie Multi Layer Perceptron) à chaque token d'une couche.
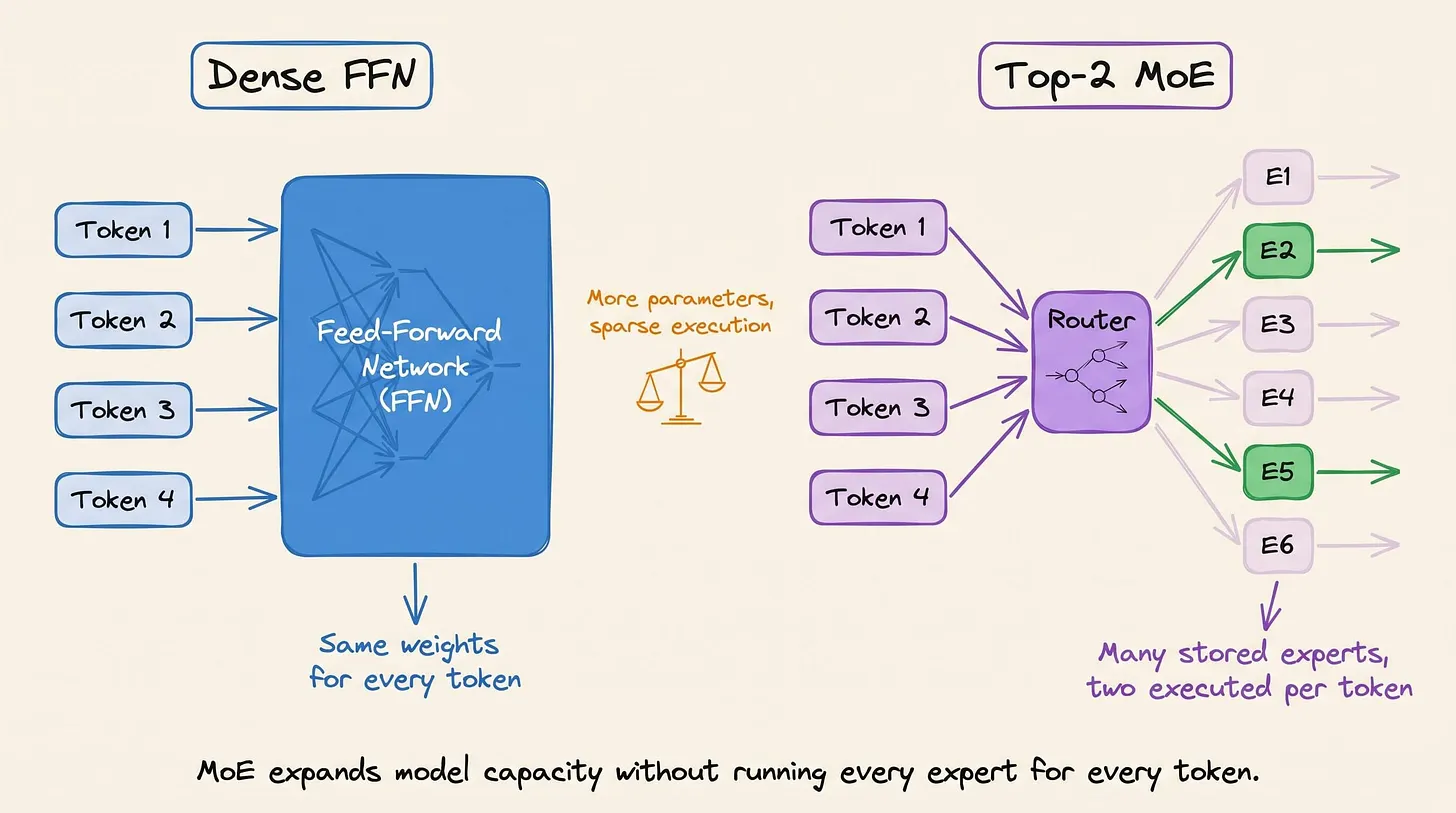
Une couche MoE remplace ce réseau par plusieurs experts. Chaque expert est un réseau feed-forward avec ses propres poids.
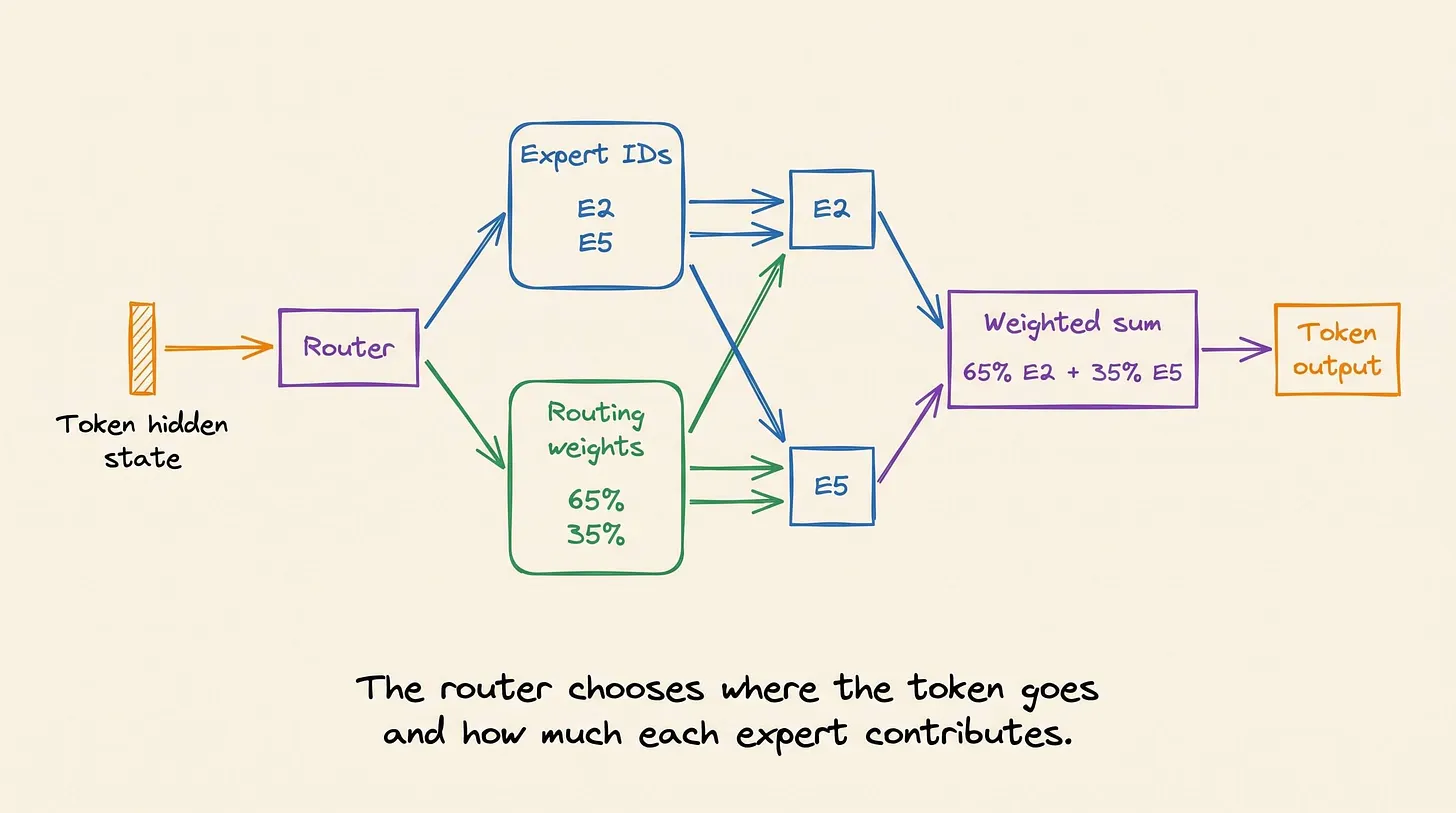
Un routeur lit le vecteur d'état caché de chaque token, évalue les experts disponibles et en sélectionne les deux premiers (top-k=2). Il produit également un poids de routage pour chaque sélection.
 Seuls les experts sélectionnés traitent le token. Le modèle contient donc de nombreux poids d'experts tout en n'exécutant qu'un petit sous-ensemble pour chaque token.
Le système de serving doit déplacer les activations lorsque les experts sélectionnés sont stockés sur des GPU différents.
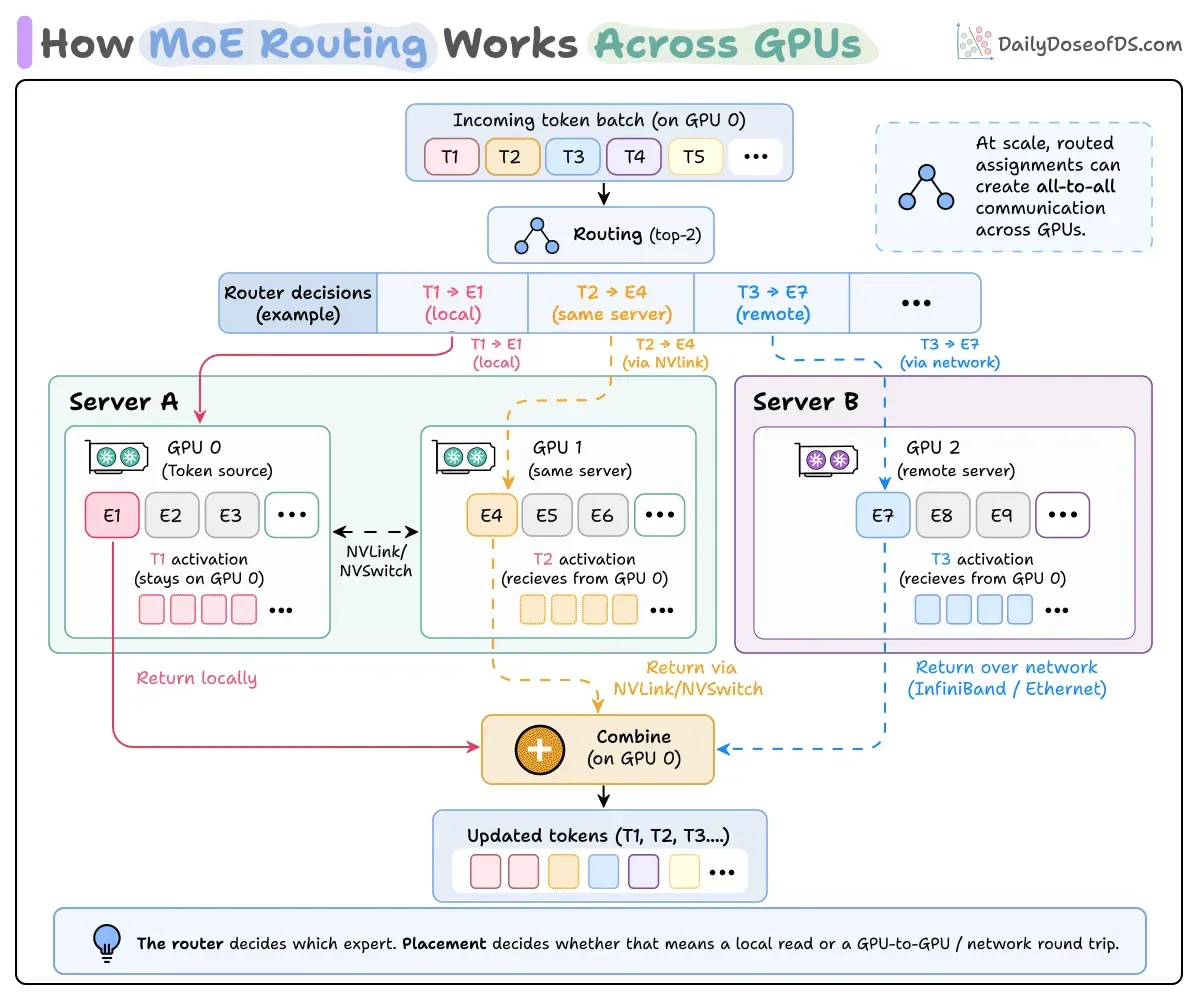
L'illustration suit un lot qui commence sur le GPU 0.
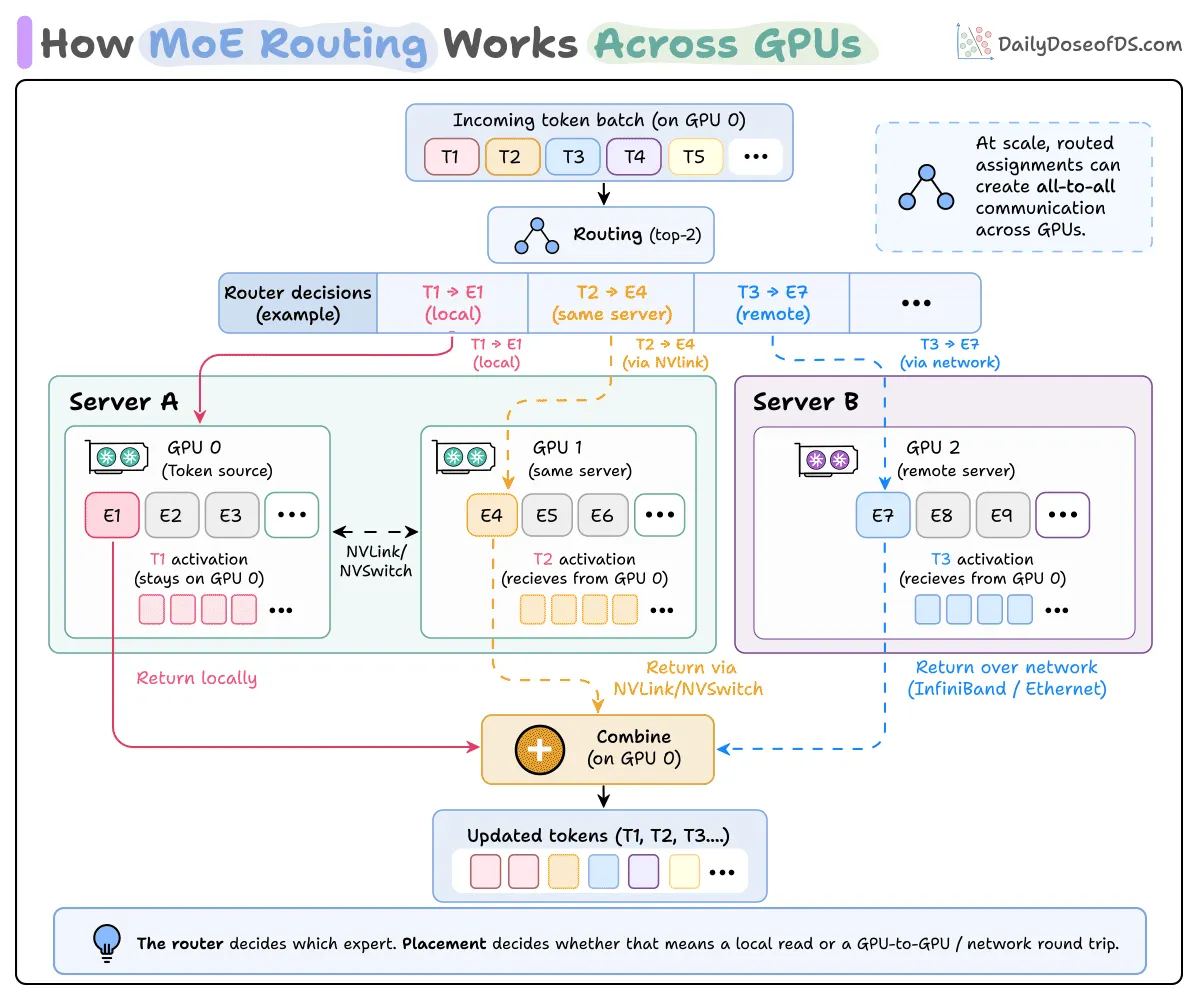
Le routeur renvoie deux identifiants d'expert et deux poids de routage par token. Un seul chemin sélectionné est montré pour chaque token d'exemple afin de garder le schéma lisible.
- Le token T1 sélectionne E1 sur le GPU 0. Son activation reste dans la mémoire locale du GPU, où E1 la traite.
- T2 sélectionne E4 sur le GPU 1 du même serveur. Le GPU 0 transfère l'activation via NVLink, une connexion GPU-à-GPU à haut débit. NVSwitch relie plusieurs GPU à travers cette architecture.
- T3 sélectionne E7 sur le GPU 2 d'un autre serveur. Son activation traverse le réseau du cluster via InfiniBand ou Ethernet.
Pour être précis, le système transfère des vecteurs d'activation, qui sont les représentations numériques produites pour un token par les opérations Transformer précédentes.
Chaque GPU de destination exécute son expert et renvoie le résultat au GPU 0.
Le GPU 0 multiplie les deux sorties d'experts sélectionnées par leurs poids de routage, les additionne et restaure l'ordre original des tokens.
Différents tokens peuvent sélectionner différentes paires d'experts. Au sein d'un lot, ces affectations peuvent impliquer chaque GPU hébergeant des experts.
Chaque GPU peut donc envoyer des activations vers plusieurs GPU tout en recevant des activations pour ses propres experts. Cet échange s'appelle la communication all-to-all.
Et il existe plusieurs façons d'optimiser cela.
Par exemple, garder les experts fréquemment sélectionnés dans le même serveur réduit le trafic distant.
Un routage équilibré évite qu'un seul GPU retarde la couche.
Le chevauchement des communications permet à la computation des experts locaux de se poursuivre pendant que les activations distantes se déplacent.
Dans cette configuration, le routage éparse réduit les FLOPs des experts, mais la distribution des tokens et la communication réseau effacent une partie de ce gain.