« Expliquez l'attention » — à la main
Article 3 de la série The AI Engineer Loop — A quoi ressemble un entretien d'AI Engineer en 2026, question par question. English version.
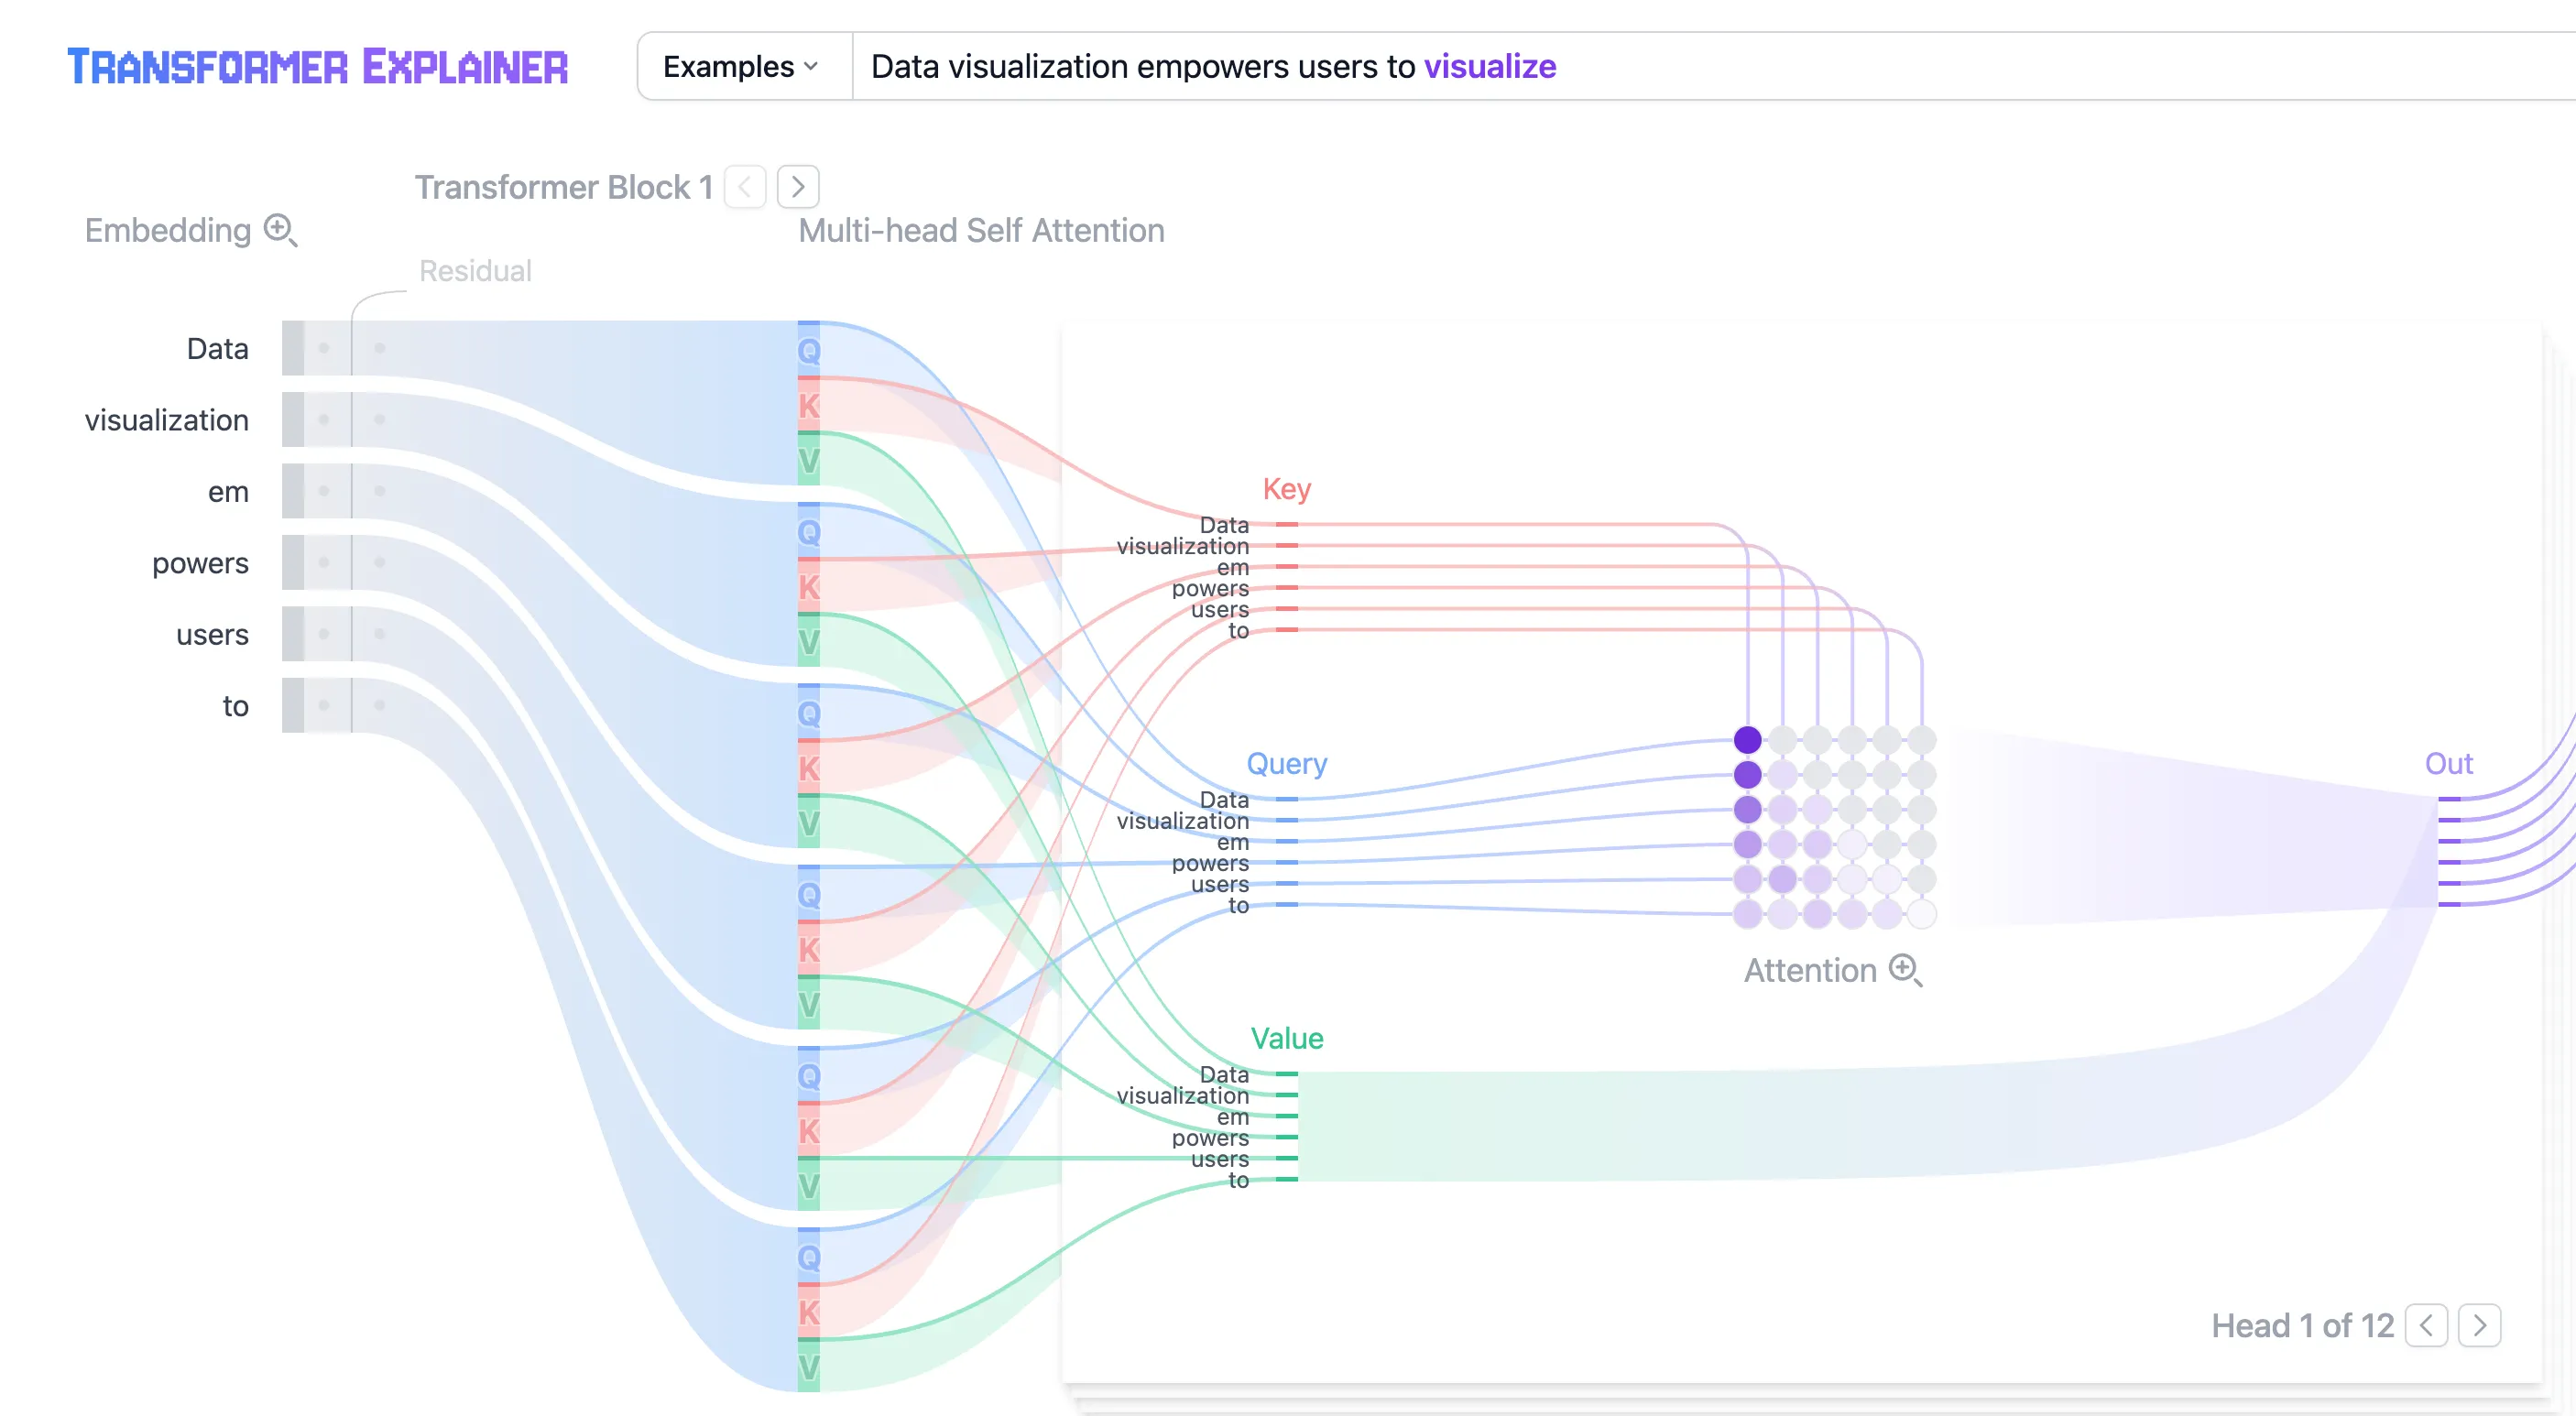
La principale question posée ici portera sur un mécanisme, dans un transformer, qu'on vous demandera d'expliquer. Pas la rétropropagation, pas l'optimiseur, pas le tokenizer. L'attention.
Q, K et V. Produit scalaire. Division par √d_k. Softmax. Somme pondérée. Quatre phrases que n'importe qui mémorise en un après-midi, et qui n'expliquent rien — il faut en général au moins parler de son calcul.
« Qu'est-ce que l'attention améliore, au juste ? »
Avant de dérouler le calcul, sachez répondre à celle-là. C'est la question de cadrage, et beaucoup de candidats enchaînent sur les matrices sans jamais dire à quel problème elles répondent.
Un embedding, seul, ne sait rien du contexte. La table d'embeddings est une table de correspondance : un mot, une ligne. Le mot « avocat » a une ligne, et c'est exactement la même dans « l'avocat a plaidé » et dans « l'avocat est mûr ». Le modèle démarre donc chaque phrase avec des vecteurs hors contexte, où toutes les ambiguïtés de la langue sont encore intactes.
Ce que l'attention améliore, c'est précisément ça : elle transforme des vecteurs hors contexte en vecteurs en contexte. Chaque token va chercher, chez les autres tokens de la phrase, ce qui le désambiguïse — et repart enrichi de ce qu'il a trouvé. C'est le seul endroit du transformer où les tokens se voient entre eux : le MLP qui suit traite chaque token isolément.
Dans l'exemple qu'on va calculer, « drank » entre en sachant seulement qu'il est un verbe au passé. Il ressort en sachant que son sujet est cat. Rien d'autre dans l'architecture ne sait faire ça.
Et ce qu'elle améliore par rapport à ce qui existait avant : les RNN faisaient circuler l'information de proche en proche, le long de la phrase. La distance coûtait cher — l'information se dégradait en chemin — et le calcul était séquentiel, donc impossible à paralléliser à l'entraînement. L'attention relie directement chaque paire de tokens, quelle que soit la distance qui les sépare, en une seule étape, et traite toutes les positions en parallèle.
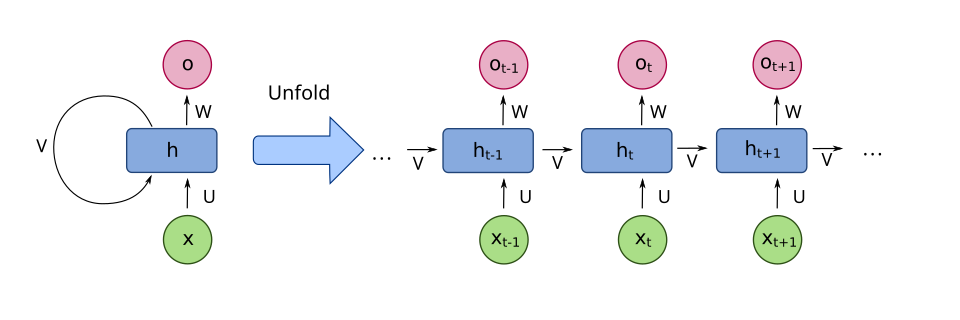
Source : « Recurrent neural network unfold », fdeloche, Wikimedia Commons, licence CC BY-SA 4.0. Rendu PNG de 960 px fourni par Wikimedia, recompressé sans perte (WebP) et hébergé sur viite.ai ; contenu inchangé. Cette image reste sous licence CC BY-SA 4.0.

La facture est dans le « chaque paire » : toutes les paires sont scorées, donc le coût est en O(n²) de la longueur de séquence. C'est la raison mécanique pour laquelle le contexte long coûte cher — et le lien direct entre ce mécanisme et votre budget de latence.
Comment calculer l'attention
Faisons ensemble un pas d'attention, en le calculant à la main, sur une phrase de quatre mots, assez petit pour que vous puissiez le refaire seul : « the hungry cat drank ». Cinq dimensions d'embedding, et une tête de dimension 2.
Les embeddings
Leur « taille », ou dimensionnalité, est notée d_model. Prenons 5 dimensions pour l'exemple.
Les vraies dimensions d'embedding ne sont pas interprétables mais faisons semblant qu'elles le soient, pour que l'arithmétique s'explique toute seule.
| token | déterminant | sujet | adjectif | verbe | passé |
|---|---|---|---|---|---|
| the | 0.9 | 0.0 | 0.1 | 0.0 | 0.0 |
| hungry | 0.0 | 0.1 | 0.9 | 0.0 | 0.0 |
| cat | 0.1 | 0.9 | 0.0 | 0.0 | 0.0 |
| drank | 0.0 | 0.1 | 0.0 | 0.9 | 0.8 |
Les trois matrices Q, K, V
Prenons de petites dimensions : 5 × 2 chacune. Ces matrices sont fournies dans le même fichier que le modèle lui-même (que vous trouvez par exemple sur Hugging Face).
Q (Query / La Requête) : C’est ce que le mot actuel "cherche" chez les autres mots de la phrase. Il pose la question : « De quoi ai-je besoin pour comprendre mon contexte actuel ? » 1
K (Key / La Clé) : C'est l'étiquette d'identification de chaque mot dans la phrase. Il répond à la question : « Qui suis-je et quel sujet j'aborde pour que les autres puissent me trouver ? » 2
V (Value / La Valeur) : C'est le contenu réel ou le sens profond du mot. Il répond à la question : « Quelle information je transmets si on me sélectionne ? »
Chaque token produit les trois à la fois. Un token est simultanément en train de demander quelque chose, d'annoncer ce qu'il est, et d'avoir quelque chose à offrir.
Leurs contenus sont les poids — la seule chose que l'entraînement modifie. Tous les tokens, à toutes les positions, utilisent ces trois mêmes matrices.
Pour comprendre le tableau qui suit, W_Q signifie weights de la matrice Q (elle-même constituée de deux colonnes, q1 et q2).
| dimension | W_Q → q1 | q2 | W_K → k1 | k2 | W_V → v1 | v2 |
|---|---|---|---|---|---|---|
| déterminant | 0.0 | 0.0 | 0.0 | 0.2 | 0.0 | 0.0 |
| sujet | 0.2 | 0.0 | 2.0 | 0.0 | 1.0 | 0.0 |
| adjectif | 0.0 | 0.2 | 0.0 | 2.0 | 0.0 | 1.0 |
| verbe | 2.0 | 0.4 | 0.2 | 0.0 | 0.1 | 0.1 |
| passé | 0.4 | 0.1 | 0.0 | 0.0 | 0.0 | 0.0 |
Lisez les colonnes comme un vecteur dont les coordonnées ont un sens sémantique déterminé lors de l'entraînement.
La colonne q1 pose un peu la question « qu'est-ce que l'embedding valorise ? ». Si l'on regarde q1 de W_Q = [0.0, 0.2, 0.0, 2.0, 0.4] (à lire verticalement ci-dessus), ce qui est mis en avant est un verbe (2.0 domine).
Étape 1 — projeter les tokens de la requête sur Q
Par exemple « drank » sur la query Q
q = e_drank × W_Q
e_drank = [0.0, 0.1, 0.0, 0.9, 0.8]
q1 de W_Q = [0.0, 0.2, 0.0, 2.0, 0.4]
q2 de W_Q = [0.0, 0.0, 0.2, 0.4, 0.1]

q1 = 0.0(0.0) + 0.1(0.2) + 0.0(0.0) + 0.9(2.0) + 0.8(0.4)
   = 0      + 0.02    + 0      + 1.80    + 0.32   = 2.14
q2 = 0.0(0.0) + 0.1(0.0) + 0.0(0.2) + 0.9(0.4) + 0.8(0.1)
   = 0      + 0       + 0      + 0.36    + 0.08   = 0.44

q(drank) = [2.14, 0.44]
Étape 2 — projeter chaque token sur K et V
Même arithmétique avec W_K et W_V. Pour cat, e = [0.1, 0.9, 0.0, 0.0, 0.0] :
k1 = 0.1(0.0) + 0.9(2.0) = 1.80        v1 = 0.9(1.0) = 0.90
k2 = 0.1(0.2) + 0.9(0.0) = 0.02        v2 = 0.9(0.0) = 0.00
Sur toute la requête, on aura :
| token | k1 | k2 | v1 (qui) | v2 (qualité) |
|---|---|---|---|---|
| the | 0.00 | 0.38 | 0.00 | 0.10 |
| hungry | 0.20 | 1.80 | 0.10 | 0.90 |
| cat | 1.80 | 0.02 | 0.90 | 0.00 |
| drank | 0.38 | 0.00 | 0.19 | 0.09 |
Étape 3 — scorer, mettre à l'échelle, softmax
Il s'agit ici de définir un score pour chaque token, et d'appliquer une technique de normalisation de données (principalement pour éviter de saturer le softmax — qui est une courbe en "S" qui tend vers une valeur limite en bas et en haut si on est trop aux extrémités)
score = (q · k) / √d_k        d_k = 2, donc √d_k ≈ 1.414

the     2.14(0.00) + 0.44(0.38) = 0.167  →  0.167/1.414 = 0.118
hungry  2.14(0.20) + 0.44(1.80) = 1.220  →  1.220/1.414 = 0.863
cat     2.14(1.80) + 0.44(0.02) = 3.861  →  3.861/1.414 = 2.730
drank   2.14(0.38) + 0.44(0.00) = 0.813  →  0.813/1.414 = 0.575

exp(0.118)=1.13   exp(0.863)=2.37   exp(2.730)=15.33   exp(0.575)=1.78
somme = 20.61

poids     the     1.13/20.61 = 0.05
          hungry  2.37/20.61 = 0.12
          cat    15.33/20.61 = 0.74      ← plus élevé
          drank   1.78/20.61 = 0.09

(somme = 1.00)
Regardez ce que l'exponentielle a fait. Avant le softmax, cat scorait environ 3× hungry. Après, cat détient 6× le poids. Le softmax ne normalise pas seulement — il durcit, et c'est pour ça que le facteur d'échelle devant lui compte.
Étape 4 — mélanger les valeurs et en déduire la valeur de l'attention
out = Σ poids × v

out1 = 0.05(0.00) + 0.12(0.10) + 0.74(0.90) + 0.09(0.19) = 0.70
out2 = 0.05(0.10) + 0.12(0.90) + 0.74(0.00) + 0.09(0.09) = 0.12

sortie d'attention pour « drank » = [0.70, 0.12]
Ce qui vient de se passer. Le verbe est entré en sachant seulement qu'il était un verbe au passé. Il ressort en portant 0.70 de qui et une faible valeur de qualité — il a "absorbé" cat, faiblement teinté de hungry. Ce vecteur est rajouté dans la suite du processus : toutes les couches au-dessus voient désormais un « drank » qui connaît son sujet (cat).
Rien n'a choisi cat. Aucune règle ne s'est déclenchée. Un produit scalaire entre deux projections est sorti grand, et un softmax en a fait les trois quarts du poids total de l'attention.
Par ce calcul subtil, on a enrichi la simple information « drank » en la reliant à son sujet, « cat ».
Quatre points à savoir
L'échelle. Le vrai d_k vaut en général 64–128, pas 2, et d_model se compte en milliers. Le diviseur √d_k compte d'autant plus qu'il grandit : sans lui, les produits scalaires deviennent grands, le softmax sature, et les gradients disparaissent.
Le parallélisme. Chaque token calcule sa propre query en même temps. Les quatre étapes de calcul ci-dessus sont une multiplication matricielle, pas une séquence d'opérations en série au fur et à mesure que l'on avance d'un token dans la requête.
Les têtes multiples. Nous n'avons ici qu'une tête. Il y en a en général 32 avec des W_Q/W_K/W_V différents et l'une suivra les sujets pendant qu'une autre suit les adjectifs ; on concatène les sorties et on reprojette vers d_model. Une tête n'est pas un modèle à part — dans un vrai checkpoint, c'est une tranche de colonnes dans l'unique W_Q de la couche.
Le masque. drank est le dernier token, donc rien n'a été masqué. Si on avait fait le calcul depuis cat, les scores de drank auraient été mis à -inf avant le softmax — poids exactement 0 pour éviter sa prise en compte. C'est cette contrainte qui rend possible l'entraînement en prédiction du token suivant sur toute la séquence d'un coup.
La phrase à prononcer en entretien
Chaque token se projette en query, key et value. On score chaque paire par query·key, on divise par √d_k pour que le softmax ne sature pas, on applique le softmax pour obtenir des poids, puis on fait la somme pondérée des values. Toutes les paires (token i, token j) sont scorées : c'est O(n²) en longueur de séquence — la raison mécanique pour laquelle le contexte long coûte cher.
Signal d'alarme : citer le papier et s'arrêter. « Attention Is All You Need, 2017, scaled dot-product attention » est une référence, pas une explication. Si vous ne pouvez pas dire ce que porte un vecteur de valeur ni pourquoi la division est là, la citation ne comptera pas comme une bonne réponse.
Pour aller plus loin
Si vous préférez voir le mécanisme plutôt que le lire :
Vidéo : « Attention in transformers, step-by-step | Deep Learning Chapter 6 », par 3Blue1Brown — Voir sur YouTube.
Et pour l'angle Q, K, V — l'histoire de cette notation et la façon dont les trois se combinent — la vidéo « How to explain Q, K and V of Self Attention in Transformers (BERT)? », par Discover AI.
Article suivant de la série The AI Engineer Loop : où vivent réellement W_Q, W_K et W_V dans un checkpoint — et pourquoi « les matrices KV » et « le KV cache » sont deux objets complètement différents.
Chez Viite, nous simplifions les processus d'entreprise avec l'IA, mais pour l'humain. Nous éditons aussi l'application Business Studio pour gérer vos vies privées ou pros.